
O "Choque de Tokens": Por que 68% dos Projetos de IA Estouram o Orçamento (e Como o Semantic Caching Salva o ROI)
Ronaldo Nunes, MSc. Eng.
CEO MovvaTech | Arquitetura de Hiperautomação & IA Agêntica | Leitura: 8 min | Publicado em 20/10/2026
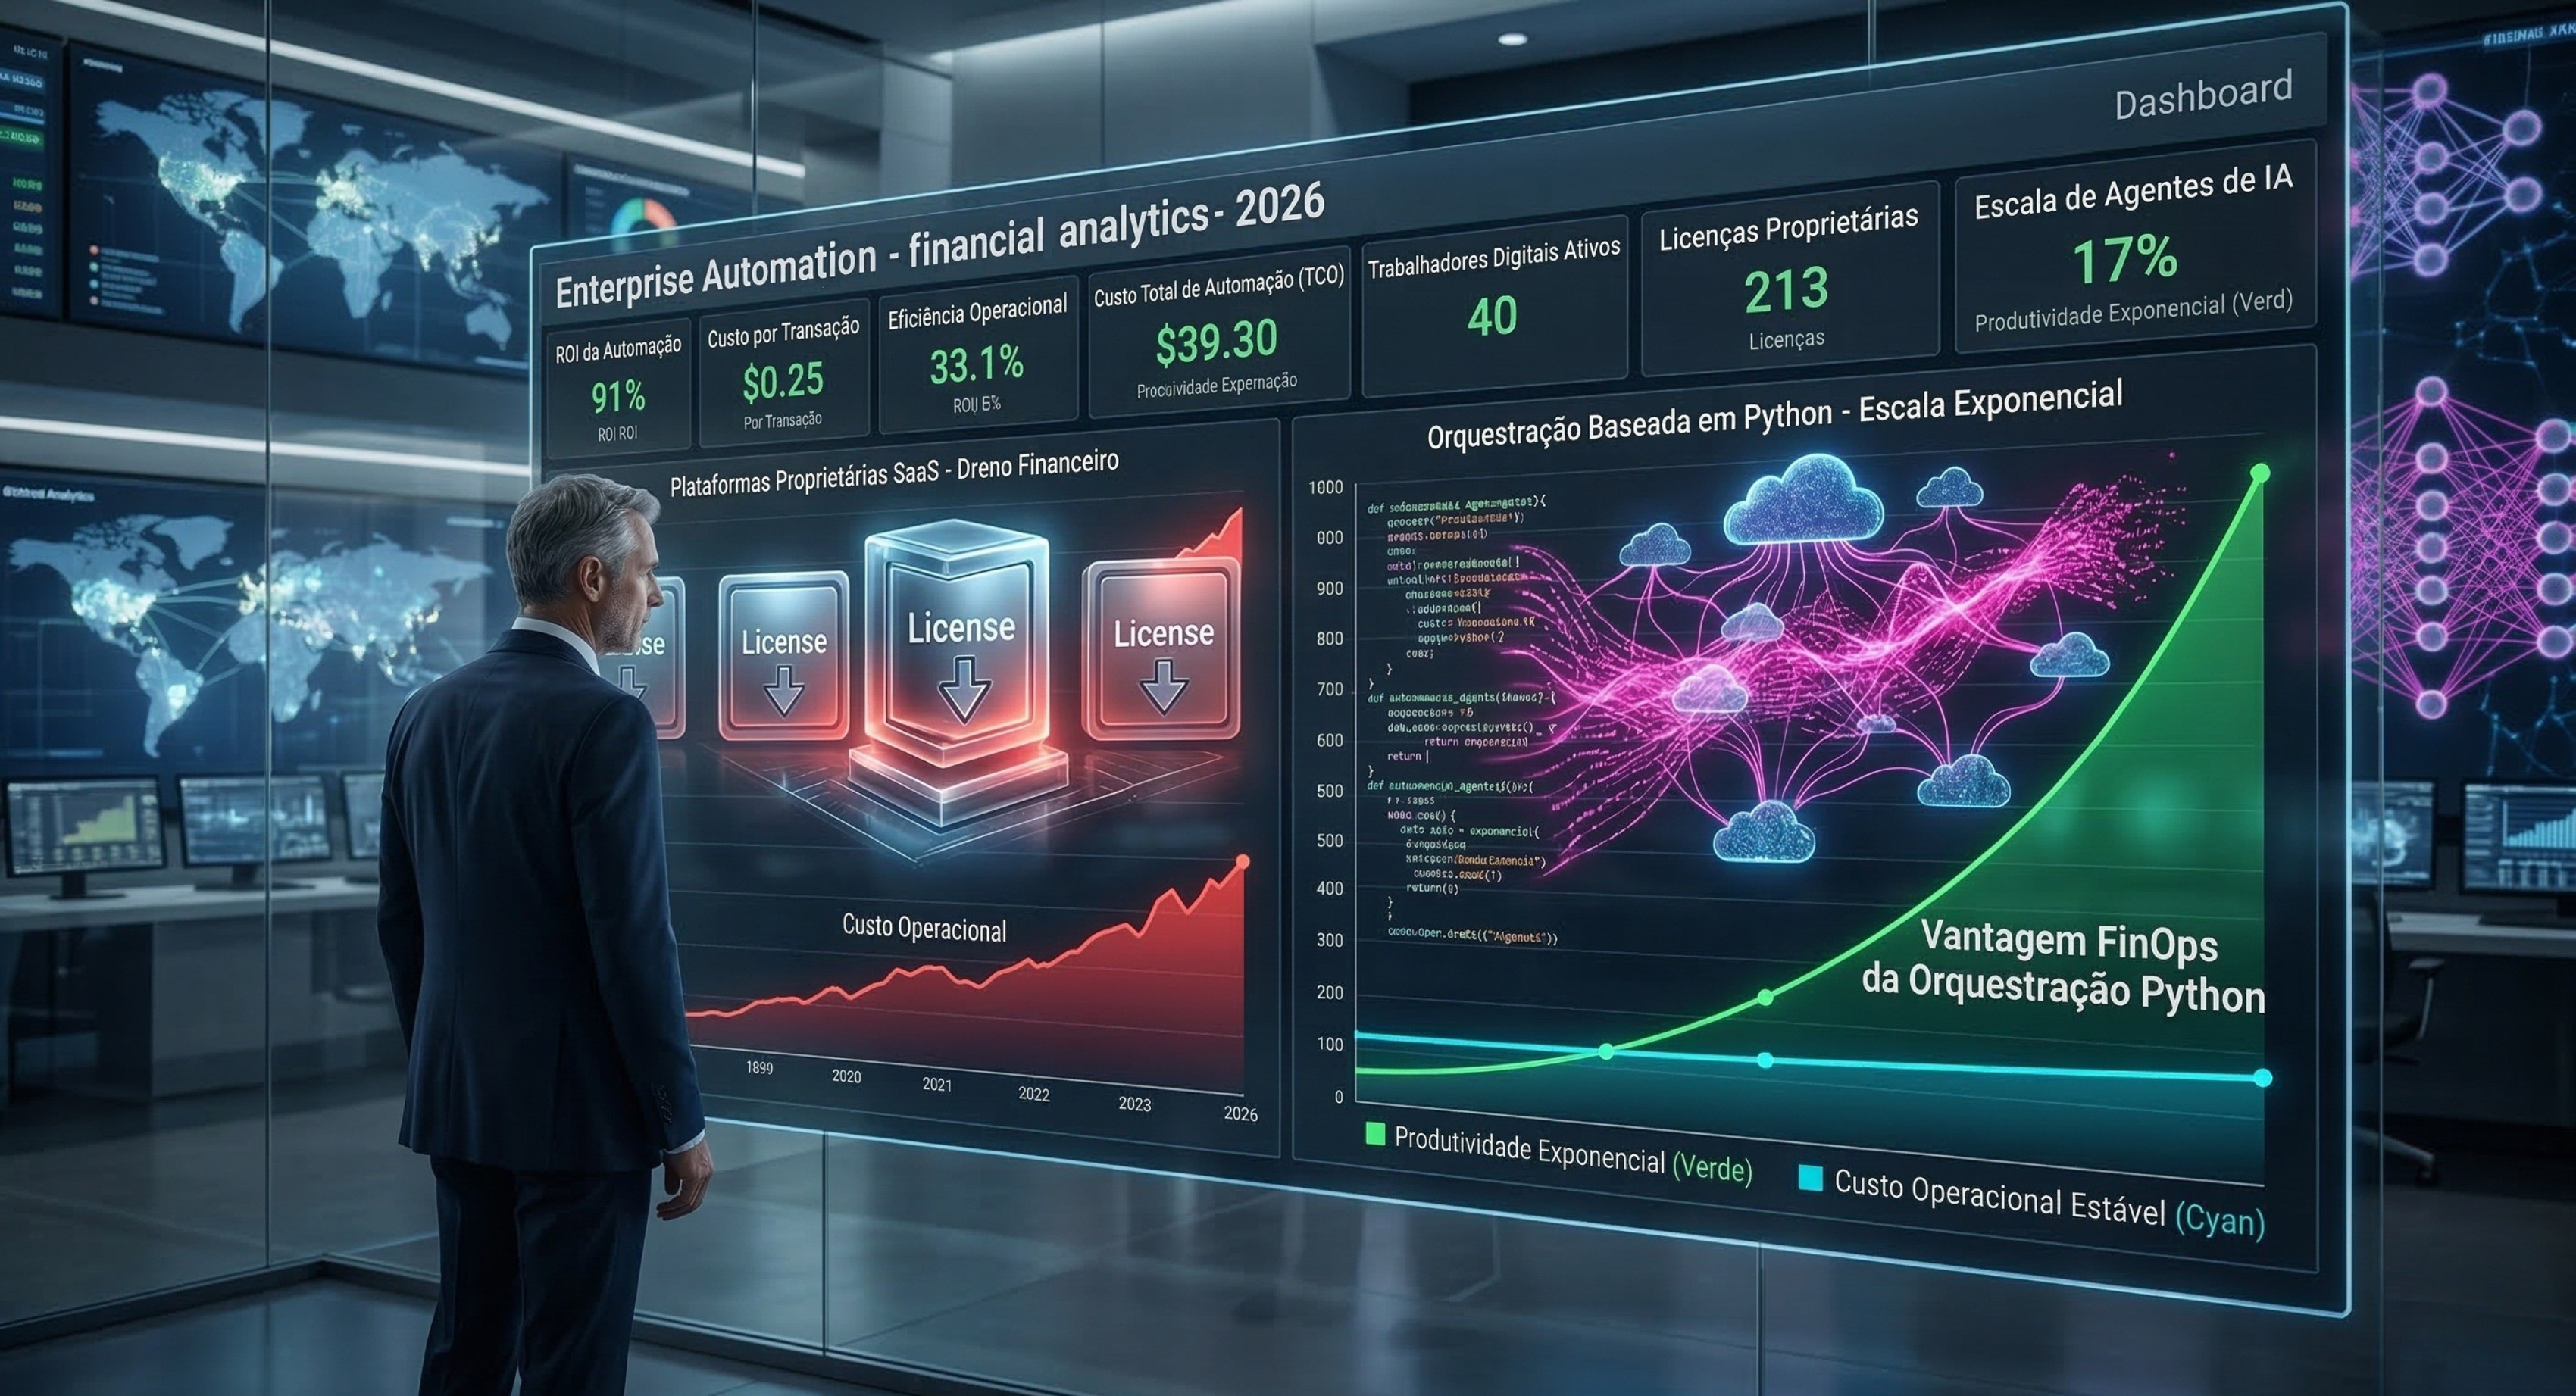
Por que um piloto de IA que custava US$ 200 por mês no laboratório salta para US$ 25.000 quando conectado ao fluxo real de faturas e atendimento? Descubra a engenharia de FinOps que reduz em até 60% a conta de inferência sem sacrificar a inteligência.
Em 2025 e 2026, um fenômeno silencioso passou a dominar as reuniões de comitê entre CIOs e CFOs: projetos de Inteligência Artificial Generativa que funcionavam perfeitamente como prova de conceito (PoC) para 20 usuários tornaram-se financeiramente inviáveis quando escalados para processar 150 mil documentos fiscais, contratos ou atendimentos mensais no backoffice.
De acordo com pesquisas recentes do Gartner sobre estrutura de custos em IA Generativa, organizações que escalam agentes sem uma camada de governança financeira cometem erros de estimativa de custos de 500% a 1.000% na transição do piloto para a produção. Paralelamente, o relatório State of FinOps da FinOps Foundation aponta o controle de gastos com inferência de LLMs como a prioridade número um de governança de nuvem.
01. A Anatomia do Desperdício de Tokens no Backoffice
Quando auditamos arquiteturas de IA implementadas sem um gateway dedicado, encontramos invariavelmente três ralos financeiros graves que corroem a margem operacional:
Consultas Repetidas ao Modelo
Na validação de NCMs fiscais, cláusulas padrão de contratos ou dúvidas de RH, até 62% das perguntas ou trechos enviados à LLM são semanticamente idênticos a requisições feitas horas antes — pagando duas vezes pelo mesmo raciocínio.
Modelos Frontier para Tarefas Simples
Usar um modelo de fronteira de alto custo (como GPT-4o ou Claude 3.5 Sonnet) apenas para extrair CNPJ, data de vencimento e valor de uma DANFE é o equivalente a contratar um PhD em astrofísica para somar planilhas.
Fatura Única Sem Chargeback
A TI recebe uma fatura unificada de US$ 18.000 em créditos de API sem conseguir responder à Controladoria quanto daquilo foi consumido pelo Jurídico, pelo Fiscal, pelo Atendimento ou por loops infinitos de agentes mal calibrados.
02. A Engenharia do Corte de 60%: Semantic Caching + Roteamento Multi-LLM
A resposta da engenharia de elite para o "Choque de Tokens" não é frear a adoção de IA, mas posicionar um AI Gateway entre os seus agentes e os provedores de modelos (OpenAI, Anthropic, Google Vertex AI, AWS Bedrock ou modelos locais via Ollama/vLLM).
No Movva AI Gateway, cada requisição passa por um pipeline de otimização financeira e técnica em milissegundos:
- Semantic Caching Vetorial: Diferente de um cache tradicional de chave exata, o cache semântico compreende que "Qual a alíquota de ICMS interestadual para o NCM 8471.30.12?" e "Verifique a tributação de ICMS para o item NCM 84713012" têm o mesmo significado, devolvendo a resposta validada em menos de 12ms a custo zero de inferência.
- Arbitragem entre SLMs e LLMs: Estudos do MIT CSAIL e da McKinsey demonstram que Small Language Models (SLMs) ajustados para tarefas específicas entregam precisão equivalente a modelos gigantes em 80% das rotinas de classificação e extração, custando até 15 vezes menos por milhão de tokens.
- Hard Caps e Circuit Breakers por Departamento: Defina tetos financeiros estritos por área de negócio. Se um script entrar em loop ou um departamento atingir 90% da cota mensal, o Gateway emite alertas imediatos e redireciona automaticamente para modelos de menor custo sem derrubar a operação.
Conclusão para o CFO e o CIO
Escalar Inteligência Artificial sem FinOps é assinar um cheque em branco para provedores de nuvem. Quando você governa cada token com Semantic Caching e roteamento inteligente, a IA deixa de ser uma despesa imprevisível de OPEX e passa a ter um custo unitário por transação previsível, auditável e decrescente.
Como implementar esta arquitetura na sua operação
A MovvaTech unifica construção de agentes, governança FinOps e orquestração Python-First sobre o seu ERP atual.
Agentes & Swarms
Crie agentes cognitivos com RAG e exporte para código Python limpo (Zero Lock-in).
02 · Movva AI GatewayFinOps & LGPD Inline
Reduza em até 60% o gasto com tokens via Semantic Caching e mascare PII antes da LLM.
03 · Movva OrchestratorTorre de Controle & ERPs
Filas determinísticas, Cofre AES-256, Action Center (HITL) e conectores SAP, TOTVS e Senior.